11 min de lectura
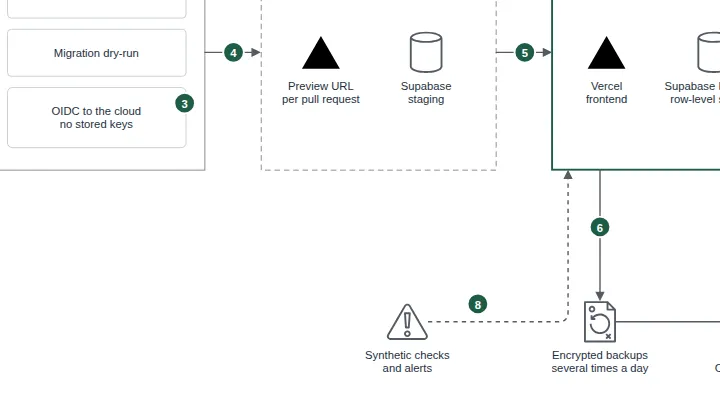
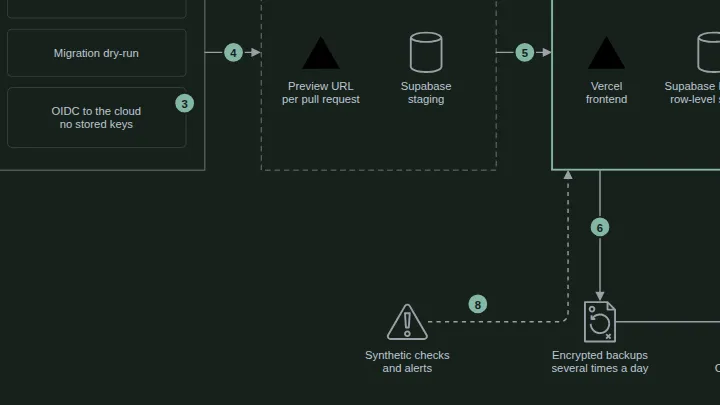
Una plataforma para centros de formación empezó en un generador de apps con IA y hoy es un SaaS multiinquilino con app web, apps nativas para iOS y Android, 160 funciones serverless y 1.048 archivos de tests automatizados. En diez meses se fusionaron 3.025 pull requests, la mayoría escritas por agentes de código y cada una revisada, probada y publicada pasando por las mismas siete etapas. Una segunda plataforma, para un negocio de hostelería, llegó a 2.133 en seis meses de la misma forma. Así es ese proceso en el día a día, ahí están las dos puertas duras y esto es lo primero que montaría si empezara de nuevo mañana.
Leer el artículo11 min de lectura
La mayoría de las medianas empresas no construyen modelos de IA. Los usan: un chatbot en la web, un asistente en ventas, Copilot en el IDE, quizá una herramienta que preclasifica candidaturas. Eso las convierte en responsables del despliegue en el lenguaje de la Ley de IA, y las obligaciones para ellos son bastante más ligeras de lo que sugieren los titulares, con algunas excepciones importantes. Desde que el AI Omnibus entró en vigor el 27 de julio de 2026, además, se han movido las fechas para los sistemas de alto riesgo. Esta es la versión práctica: qué papel tienes, en qué clase de riesgo cae cada caso de uso, qué aplica ya hoy y para qué deberías prepararte hasta diciembre de 2027. Es la visión de un ingeniero, no asesoramiento jurídico.
Leer el artículo11 min de lectura
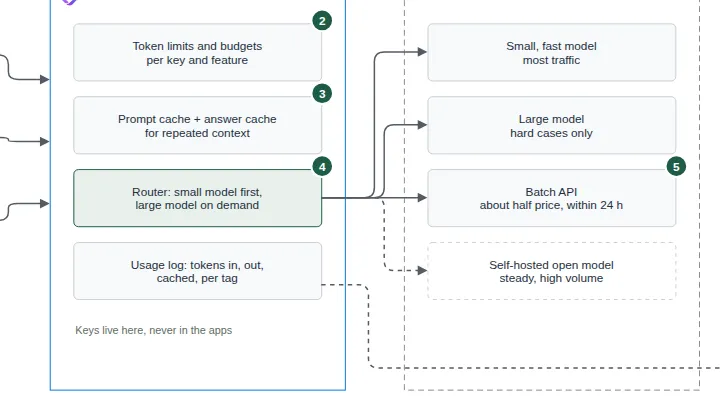
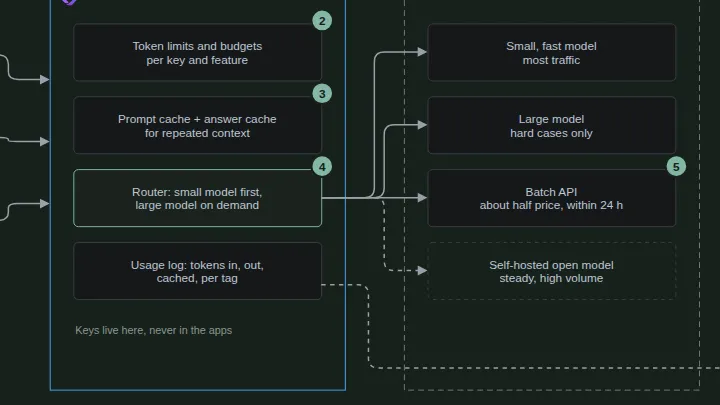
Las facturas de IA se comportan distinto que las de cloud. No hay un servidor ocioso que apagar por la noche; cada pregunta de un cliente, cada documento que lee un agente y cada reintento en un bucle se paga por token, y una sola función con un prompt de sistema largo puede costar en silencio más que el resto de la plataforma. La buena noticia: la misma disciplina que reduce los costes cloud funciona aquí, con algunas palancas nuevas. Este es el orden que sigo, con la guía de IA de esta web como ejemplo a lo largo del texto.
Leer el artículo10 min de lectura
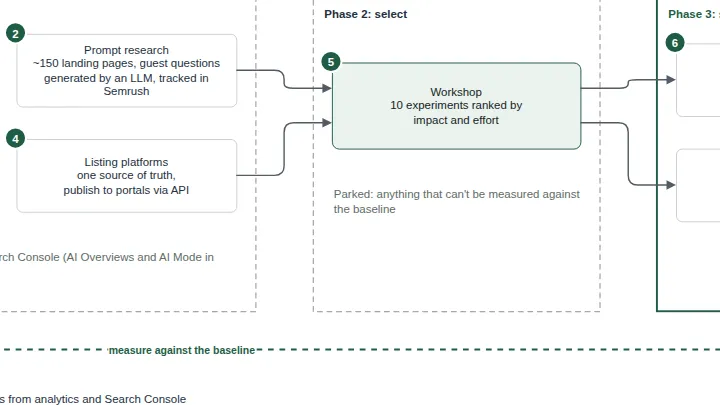
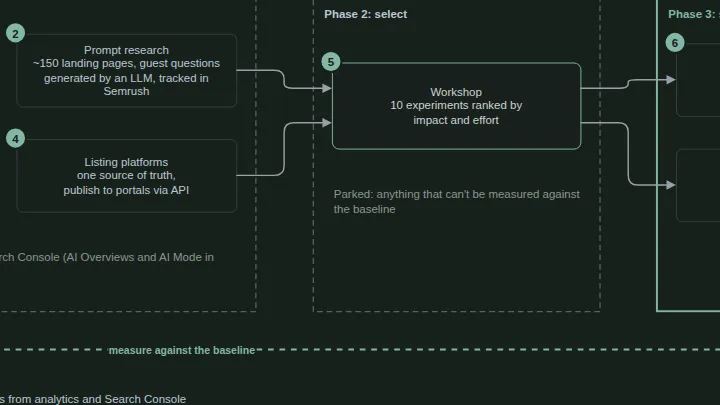
Los comensales ya no solo buscan 'restaurante cerca'. Le piden a ChatGPT un italiano tranquilo para seis el viernes, o dejan que el AI Mode de Google compare tres opciones. Una plataforma europea de hostelería con una gran red de webs de restaurantes quería saber cuántos clientes llegan ya así y cómo meter a sus restaurantes en esas respuestas. Este es el resumen anonimizado de ese proyecto: tres fases, evaluar, seleccionar y sprint, desde la primera línea base hasta diez experimentos priorizados y dos pruebas de concepto funcionando. Qué medimos, qué probamos y qué volvería a hacer igual.
Leer el artículo10 min de lectura
Esta web también es un proyecto de referencia. Tiene tres idiomas, decenas de páginas, más de una docena de herramientas interactivas y una guía de IA que responde mientras escribe. Saca 100 en las cuatro categorías de Lighthouse en móvil y funciona con los niveles gratuitos de Azure Static Web Apps y de la API de Gemini. Nada de eso necesita un stack exótico: React, Vite, un paso de prerender y un puñado de comprobaciones que se niegan a desplegar algo roto. Así encajan las piezas, incluidas dos cosas que solo descubrí midiendo.
Leer el artículo10 min de lectura
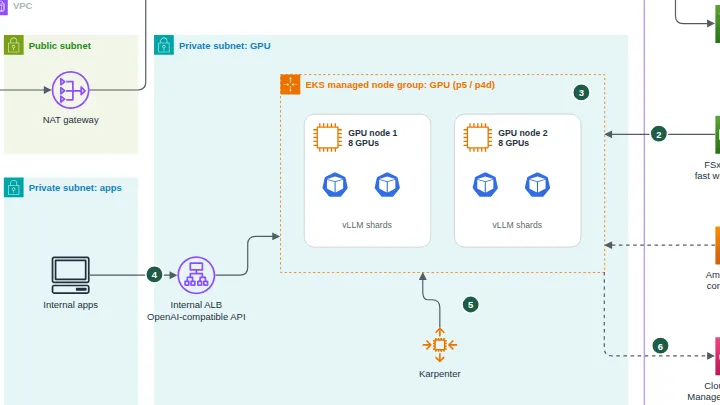
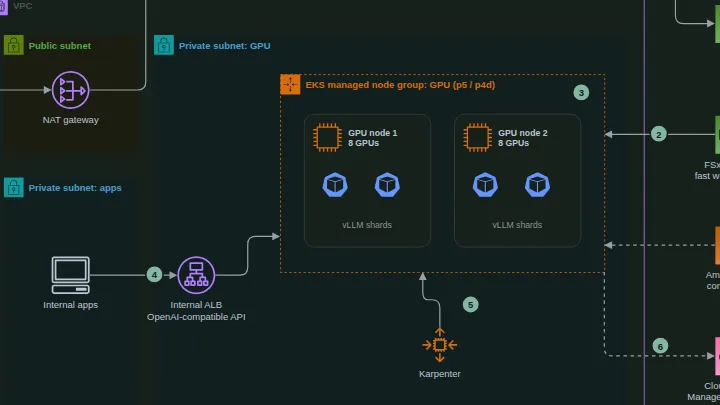
Mi método para AKS llevó un clúster de producción de 7 a 4 nodos dimensionando los requests según el uso p95 real y dejando que el autoscaler hiciera la reducción. El método vale tal cual para Amazon EKS y Google Kubernetes Engine. Lo que cambia es de dónde sale la factura y qué palancas te da cada cloud: Karpenter y split cost allocation en AWS, la facturación por Pod de Autopilot y la asignación de costes en Google Cloud. Este es el artículo complementario para ambos.
Leer el artículo11 min de lectura
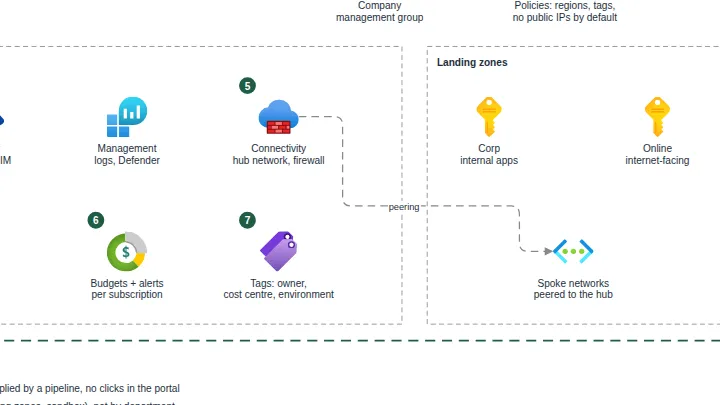
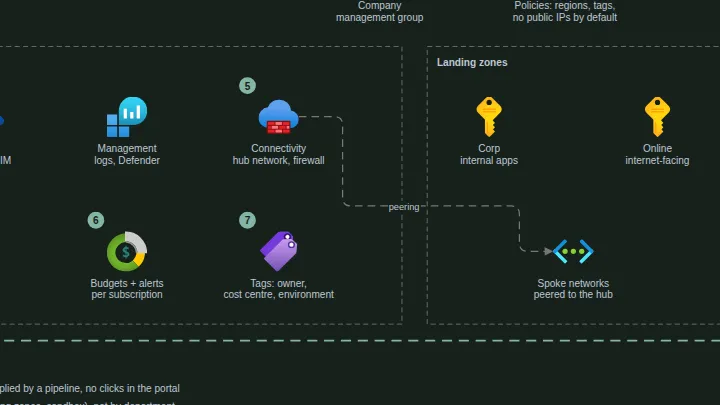
Una landing zone es el terreno preparado en el que aterrizan tus cargas cloud: la estructura de cuentas y suscripciones, las barreras, la identidad, la red, los logs y el control de costes, todo listo antes de que llegue la primera aplicación. Las arquitecturas de referencia para grandes empresas parecen necesitar un equipo de plataforma de veinte personas. Una empresa mediana necesita las mismas ideas en tamaño más pequeño, escritas como código, para que un equipo de dos pueda operarlas. Esta es la versión que construyo.
Leer el artículo11 min de lectura
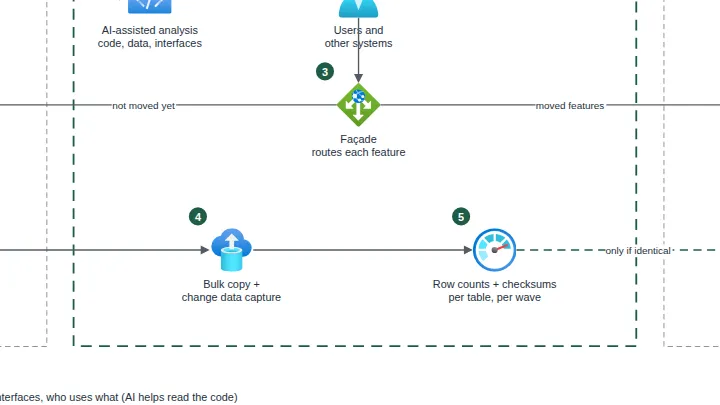
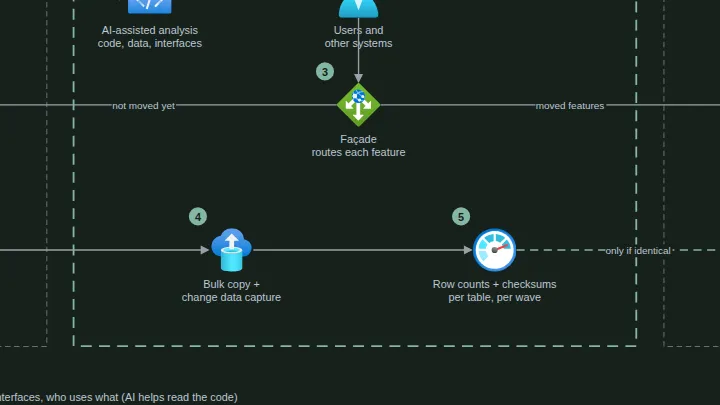
Toda empresa tiene un sistema que nadie quiere tocar: una base de datos antigua, un monolito, dos herramientas que deben seguir sincronizadas. Las migraciones de golpe de esos sistemas son donde se pierden fines de semana y reputaciones. Lo que funciona es aburrido a propósito: primero mapear, mover por oleadas, ejecutar lo viejo y lo nuevo en paralelo y cambiar solo cuando los números son idénticos. Este es el manual que uso, con los proyectos en los que funcionó.
Leer el artículo11 min de lectura
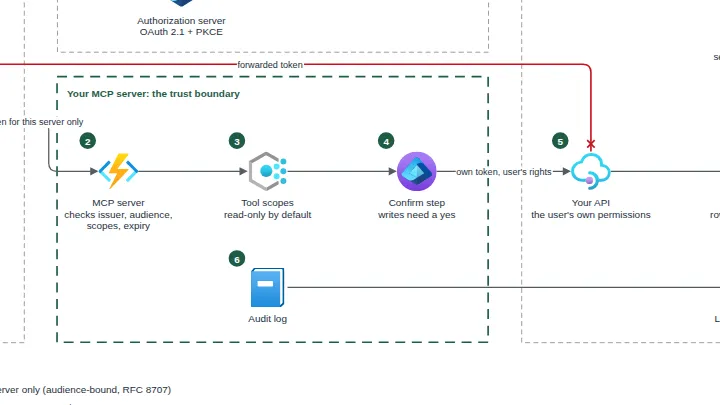
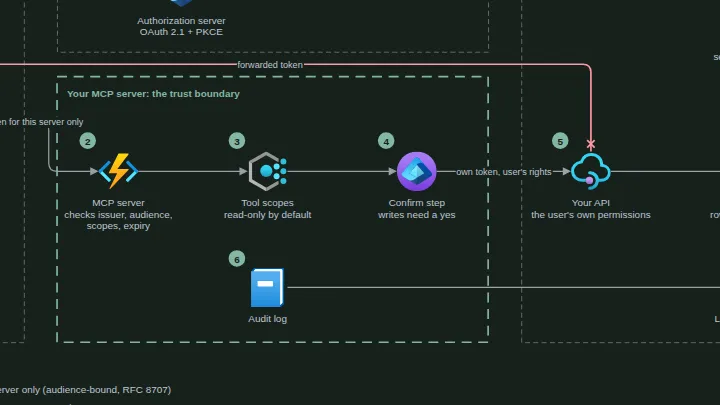
Un servidor MCP convierte tu producto en algo que Claude, ChatGPT o un agente de código pueden manejar. En un SaaS que gestiono, todo lo que se puede hacer en la interfaz también funciona por MCP, incluidas las analíticas y los datos de usuarios. Es muy potente, y significa que el servidor MCP necesita la misma seguridad que el propio producto, más algunas reglas propias: tokens ligados a un solo servidor, herramientas con los mínimos permisos posibles, un sí de la persona antes de cambiar nada y un registro de cada llamada.
Leer el artículo10 min de lectura
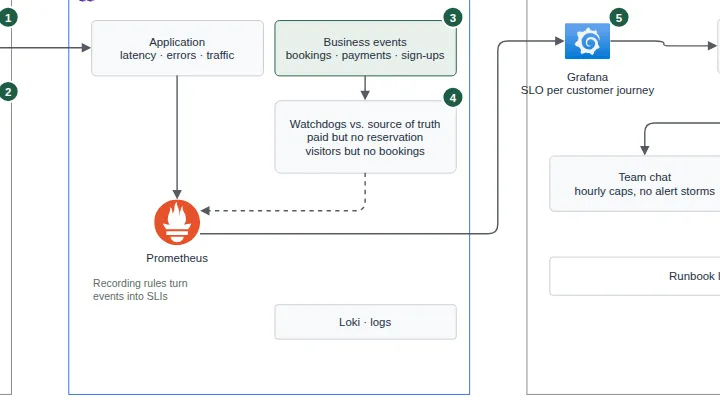
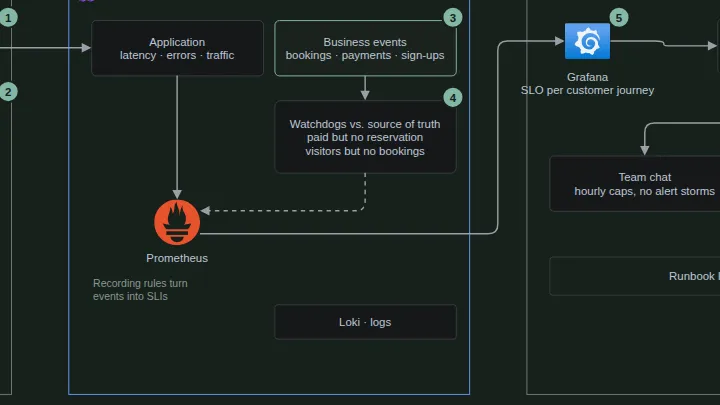
Todo equipo de plataforma conoce el momento: CPU al 30 %, ningún error en los logs, todos los paneles en verde, y hace dos horas que ningún cliente puede pagar. La monitorización clásica vigila las máquinas. Lo que el negocio necesita saber es si la gente puede hacer aquello para lo que ha venido: reservar, pagar, registrarse. Así monto una monitorización que vigila resultados, detecta los problemas desde fuera antes de que los clientes avisen y se mantiene lo bastante tranquila como para que la gente siga leyendo las alertas.
Leer el artículo10 min de lectura
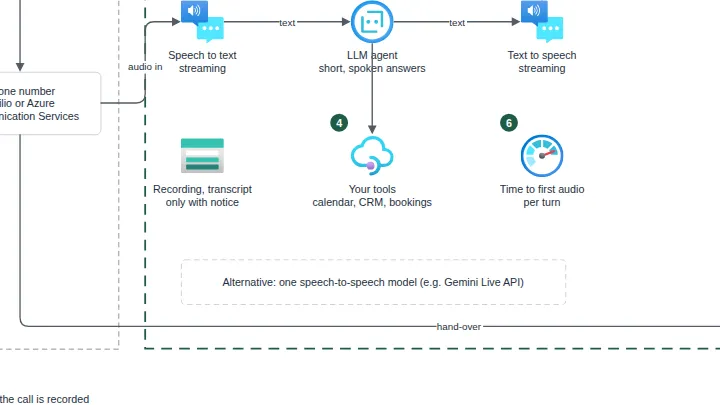
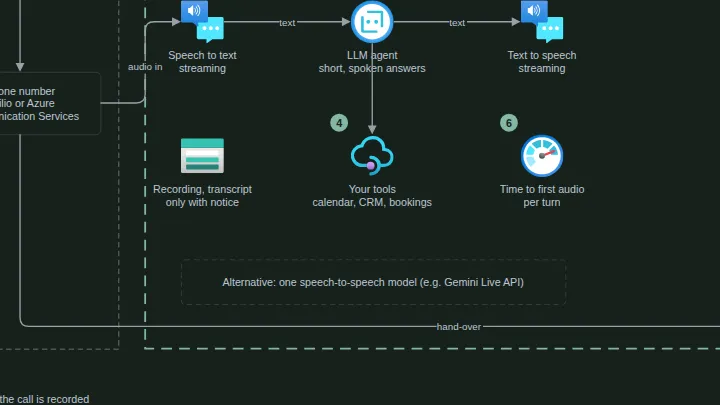
Un agente de voz que coge la llamada, reserva la cita, responde las preguntas habituales con tu base de conocimiento y pasa a una persona cuando hace falta: es uno de los proyectos de IA más pedidos ahora mismo. La demo es fácil. Lo que hace que funcione en una línea real son los tiempos, las interrupciones, un traspaso limpio y lo básico en lo legal. Esta es la arquitectura que uso y los tropiezos que conviene prever.
Leer el artículo9 min de lectura
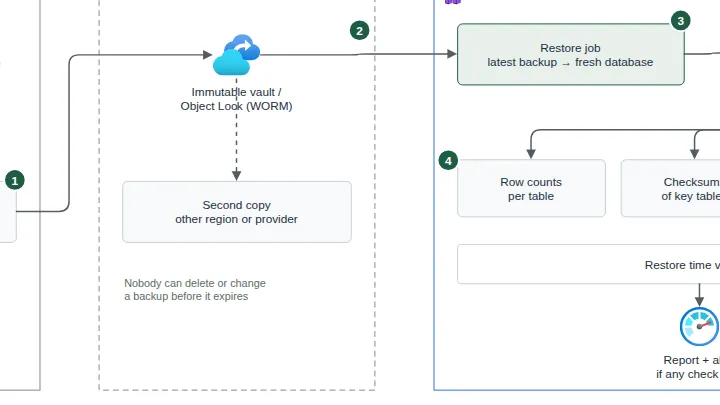
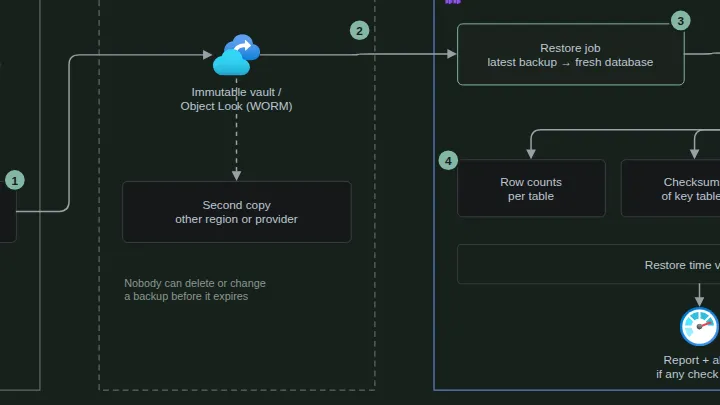
La mayoría de paneles de backup están en verde. Dicen que un job se ejecutó y que se escribió un archivo, lo que no dice nada de si puedes recuperar tu negocio a partir de ese archivo, cuánto tarda o si la copia sobrevive a un atacante con permisos de administrador. La única prueba es una restauración. En las plataformas que opero, los backups se escriben cada pocas horas fuera del proveedor de hosting y se restauran cada noche, de forma automática, en un gemelo aislado. Así se monta.
Leer el artículo10 min de lectura
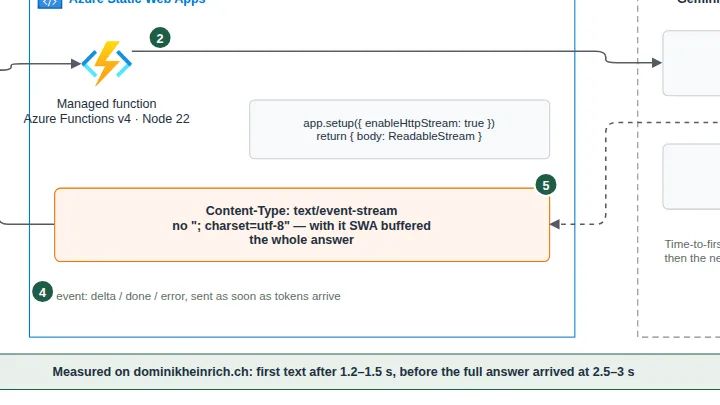
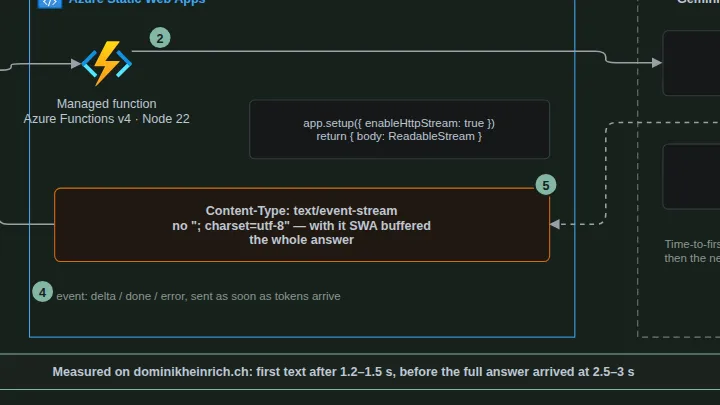
La guía de IA de esta web antes mostraba su respuesta solo cuando estaba completa: entre dos segundos y medio y tres de puntitos saltando y luego un muro de texto. El streaming lo soluciona, porque el texto aparece mientras el modelo aún escribe. Alguna documentación de frameworks dice que Azure Static Web Apps retiene todas las respuestas de las funciones, así que ahí no se podría hacer streaming. Sí se puede. Pero un pequeño detalle en una sola cabecera de respuesta retenía la respuesta entera, y hizo falta un experimento controlado para encontrarlo. Este es el montaje que funciona, el experimento y el código.
Leer el artículo11 min de lectura
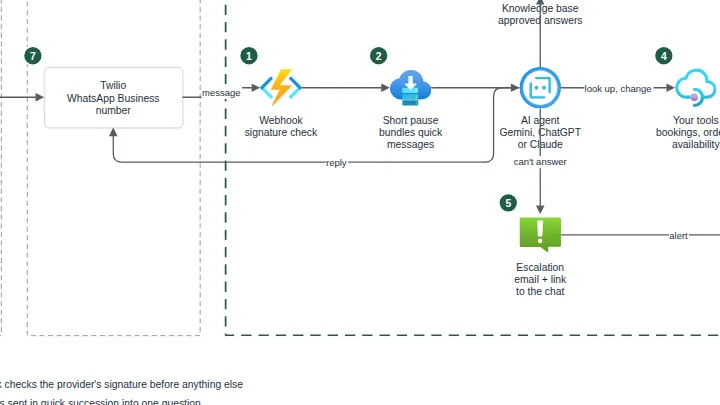
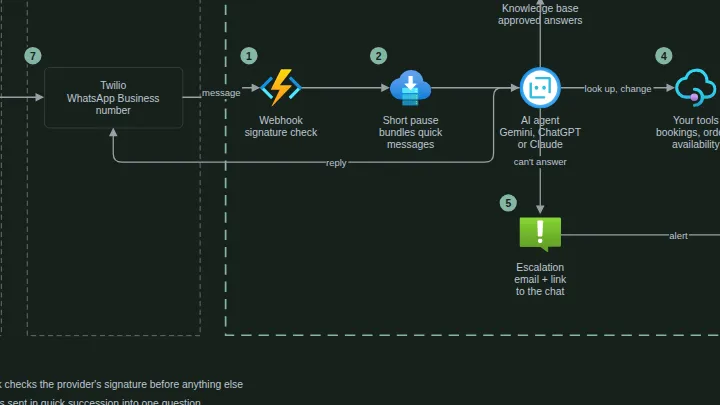
Una demo que responde un mensaje de WhatsApp con IA se hace en una tarde. Un asistente al que un negocio de hostelería le confíe sus huéspedes necesita más: responder solo lo que sabe, actuar en tus sistemas sin sorpresas, reconocer cuando no sabe algo y mejorar con las respuestas de tu equipo. Así construí StillAnswer, el asistente que funciona para una escuela de surf con hostel, y esto es lo que aprendí.
Leer el artículo10 min de lectura
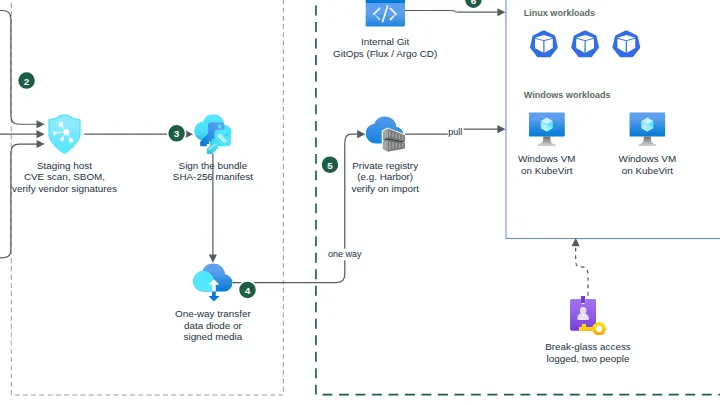
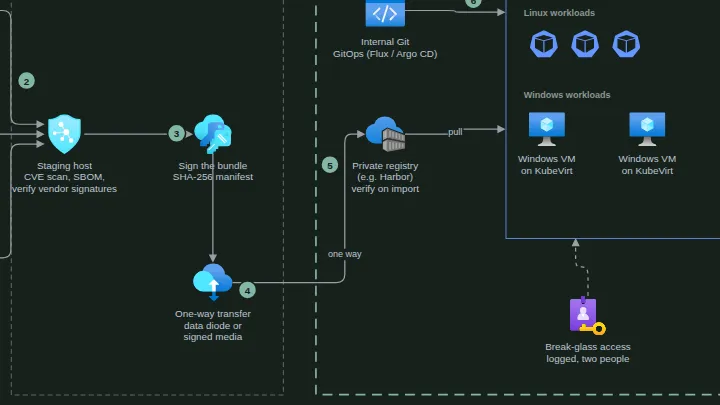
Hay sistemas que nunca deben hablar con internet: el control de una emisión en directo, la red de un hospital, una línea de producción, un laboratorio con datos sujetos a control de exportación. Durante años eso significaba renunciar a las herramientas modernas. Ya no. Kubernetes, GitOps, imágenes firmadas y una monitorización seria funcionan dentro de un enclave sin ninguna salida, siempre que trates la frontera como un proceso y no solo como un cable que falta. Así es como los construyo y los opero.
Leer el artículo11 min de lectura
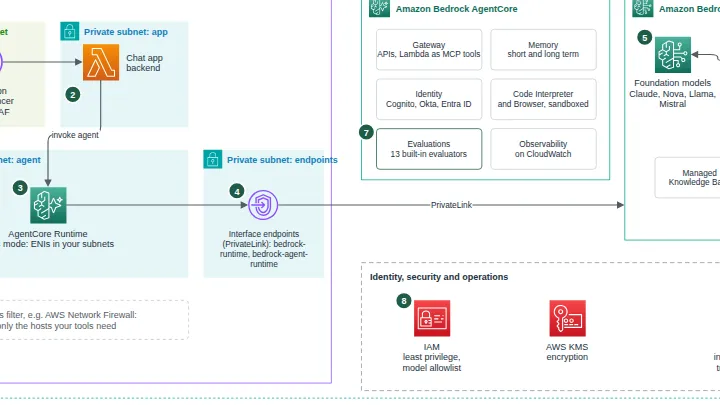
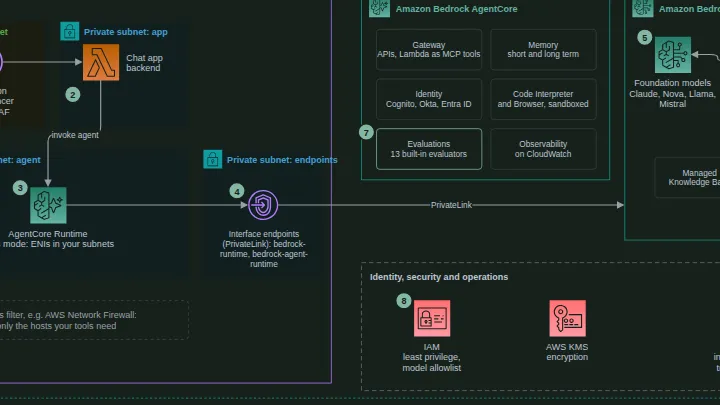
En AWS, las piezas para un agente en producción han cambiado más en los últimos doce meses que en los tres años anteriores: Bedrock Agents pasó a ser Agents Classic, AgentCore tomó el relevo como plataforma de agentes y Bedrock tiene ahora cuatro niveles de inferencia. Esta es la configuración que montaría hoy para un agente que debe superar una revisión de seguridad: IAM de mínimo privilegio, PrivateLink en lugar de internet, una base de conocimiento gestionada, guardrails en entrada y salida, evaluaciones en el pipeline y cada invocación registrada. Todos los datos enlazan con la documentación de AWS.
Leer el artículo11 min de lectura
La mayoría de los pilotos de IA en Azure empiezan con una clave copiada en una app y un endpoint de modelo abierto a internet. Sirve para una demo y suspende la primera revisión de seguridad. Esta es la configuración que uso cuando un agente tiene que salir a producción en Microsoft Foundry: Entra ID en lugar de claves, todo detrás de endpoints privados, guardrails en cada paso del agente, evaluaciones antes de cada release y trazas en Application Insights. Cada afirmación enlaza con las páginas oficiales de Microsoft para que puedas comprobarla.
Leer el artículo10 min de lectura
Si todavía escribes un prompt, esperas, lees la respuesta y escribes el siguiente, tu agente de programación es exactamente igual de rápido que tú. Claude Code tiene ya tres formas de dejarle seguir solo: /goal trabaja hasta que se cumple una condición, /loop repite un prompt cada cierto tiempo mientras tu sesión está abierta y las tareas programadas en la nube, que casi todo el mundo sigue llamando rutinas, se ejecutan con el portátil cerrado. Parecen similares, pero resuelven problemas distintos. Si eliges mal, la tarea se para demasiado pronto, no termina nunca o gasta más de tu plan de lo que ahorra. Así elijo entre ellas en proyectos con clientes y así configuro cada una para revisar resultados en lugar de cada paso.
Leer el artículo9 min de lectura
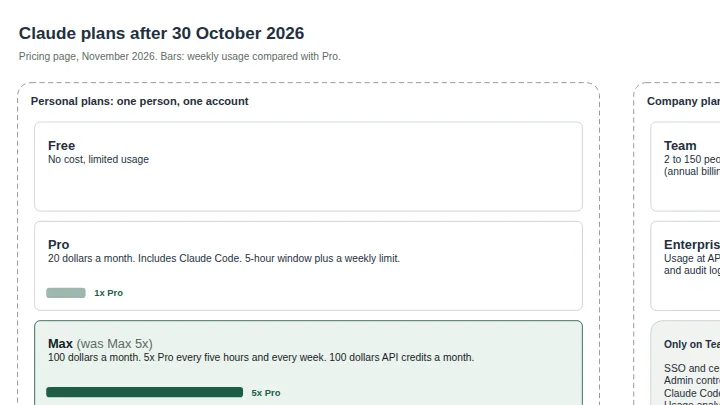
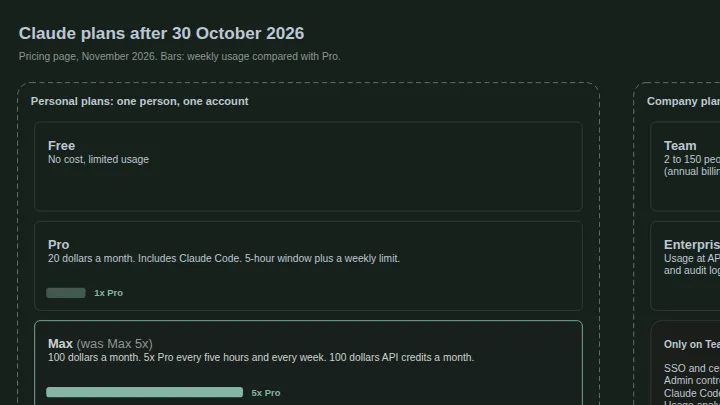
A finales de octubre Anthropic renombró sus dos planes personales más grandes y cambió cómo funcionan los límites en el mayor. Si tus ingenieros usan Claude Code todo el día, esto decide si una ejecución larga de un agente se para a media tarde y si pagas capacidad que nadie usa. El cambio en sí es pequeño. Las preguntas que plantea en las empresas son mayores: qué puestos para quién, qué cubren de verdad los nuevos créditos de API y por qué los planes personales son la respuesta equivocada para el trabajo de empresa aunque parezcan más baratos. Estos son los datos de la página de precios y el centro de ayuda de Anthropic, y cómo los gestionaría en un equipo.
Leer el artículo10 min de lectura
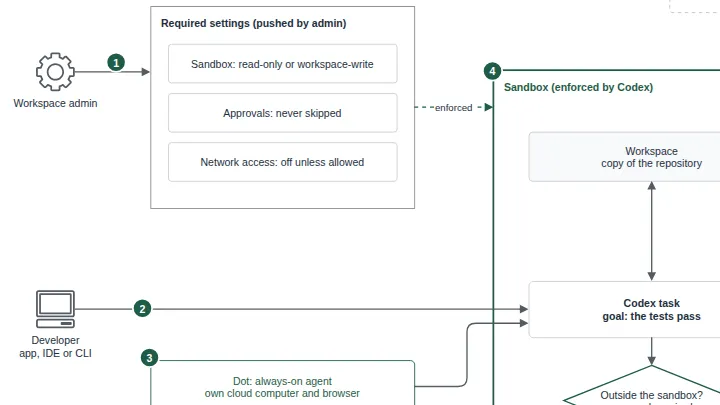
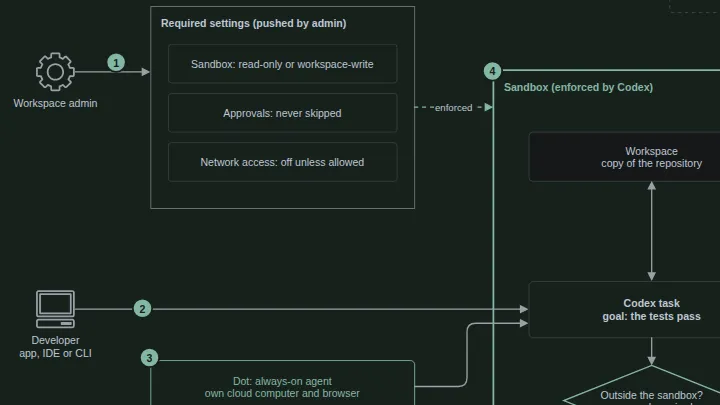
Uso Codex junto a Claude Code en mi propio trabajo, y este año ha cambiado más que cualquier otra herramienta de mi mesa. Forma parte de los planes de pago de ChatGPT, persigue un objetivo durante horas, desde septiembre existen los dots, agentes siempre activos con su propio ordenador en la nube, y a finales de octubre llegó un modelo más barato. Es mucha autonomía para dársela a un equipo de golpe. La mayor parte del riesgo no viene del modelo, sino de valores por defecto que nadie ha revisado: un sandbox más amplio de lo necesario, aprobaciones desactivadas en un portátil con acceso a producción. Esto es lo que merece la pena hoy, y estos son los ajustes exactos que configuro antes de que empiece un equipo.
Leer el artículo11 min de lectura
Me hacen esta pregunta en casi todas las primeras llamadas, casi siempre así: «¿cuál escribe mejor código?». Es la pregunta equivocada. Los tres escriben buen código, abren pull requests y pueden trabajar solos durante horas. Lo que de verdad cambia es dónde viven, hasta dónde llegan sin una persona, cómo puede controlarlos tu equipo de seguridad y cómo se facturan. Si fallas en esos cuatro puntos, acabas con tres herramientas, ninguna política central y una factura que nadie sabe explicar. Esta es la comparación que repaso con clientes, basada en la documentación y los changelogs de los propios fabricantes a noviembre de 2026, más las reglas que pongo a los tres antes de que nadie empiece.
Leer el artículo10 min de lectura
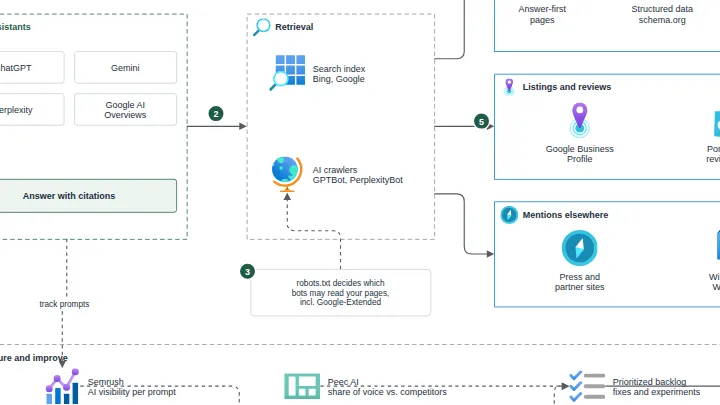
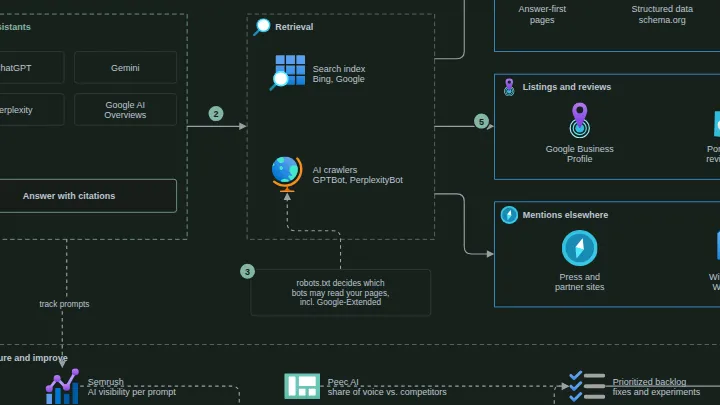
Tus clientes ya no escriben solo tres palabras clave en Google. Le hacen una pregunta completa a ChatGPT, Gemini, Perplexity o al modo IA de Google y reciben una sola respuesta con un puñado de fuentes. Si no eres una de esas fuentes, eres invisible justo cuando alguien decide. Esto es lo que es de verdad la optimización para motores generativos (GEO), lo que funciona y lo que es ruido.
Leer el artículo11 min de lectura
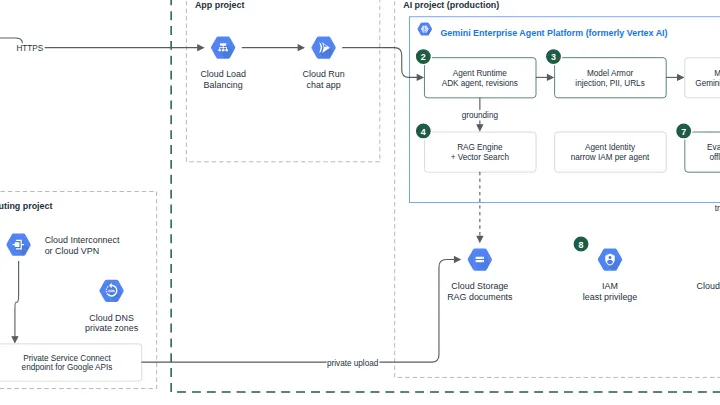
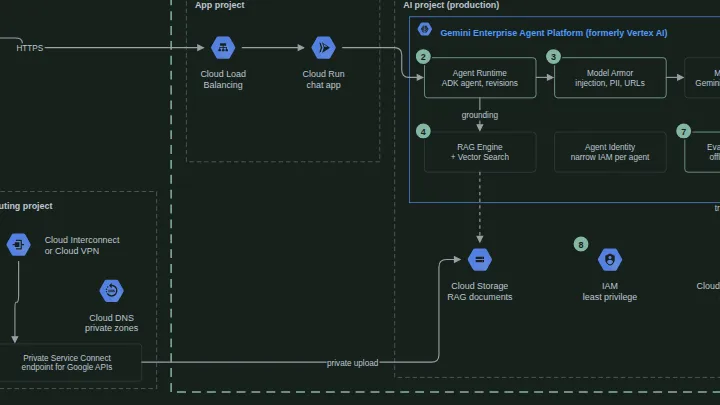
Si últimamente buscaste Vertex AI y acabaste en algo llamado Gemini Enterprise Agent Platform, no te has perdido: Google lo renombró el 22 de abril de 2026. Las piezas para un agente en producción siguen ahí, muchas con nombres nuevos. Esta es la configuración que montaría hoy: proyectos e identidades de agente separados, un perímetro de VPC Service Controls, RAG Engine sobre tus propios datos, Model Armor delante de cada llamada al modelo, evaluaciones sobre trazas reales y capacidad aprovisionada solo cuando lo justifiquen los números. Cada afirmación enlaza con la documentación de Google.
Leer el artículo10 min de lectura
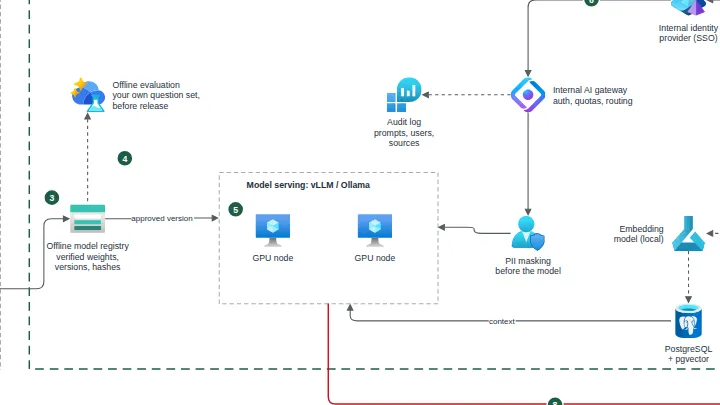
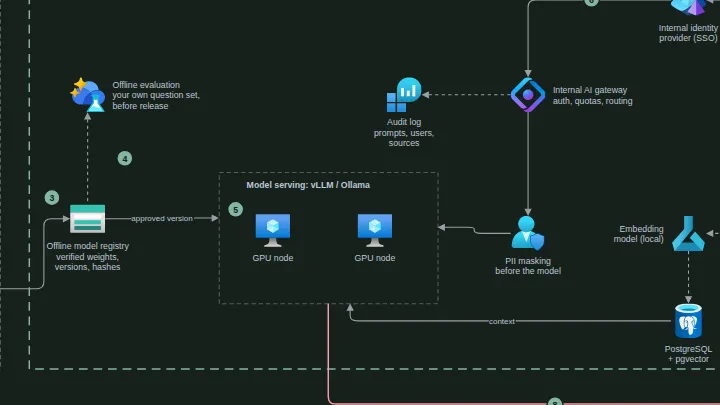
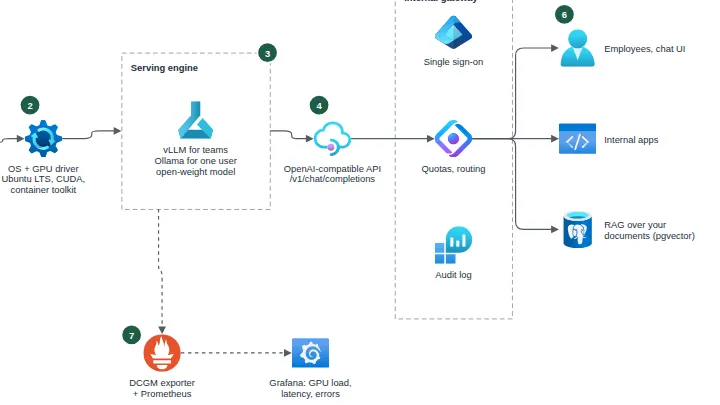
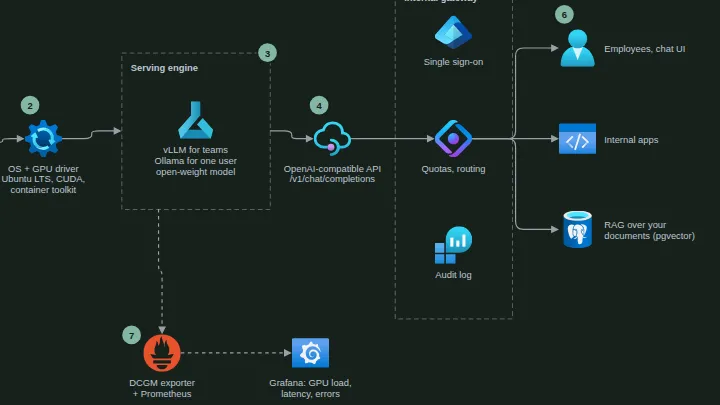
Los documentos que más se beneficiarían de la IA son justo los que nadie puede subir a ningún sitio: contratos, expedientes de personal, historiales de pacientes, código fuente, planos de ingeniería. Con un modelo de pesos abiertos dentro de una red aislada obtienes el beneficio sin que un solo byte salga del edificio. Así lo monto, así entran los modelos sin internet, así se prueban sin conexión y esto es lo que puedes esperar de forma realista.
Leer el artículo12 min de lectura
Una de cada dos conversaciones sobre IA privada termina con la misma pregunta: ¿qué hardware necesitamos de verdad? La respuesta honesta empieza por el modelo y por cuántas personas lo van a usar, no por la página de un producto. Así lo dimensiono yo, estas son las opciones actuales en noviembre de 2026 y así se convierte la máquina en un servicio que tu equipo puede usar.
Leer el artículo11 min de lectura
Los clientes con datos sensibles me siguen preguntando si los modelos abiertos ya son lo bastante buenos para ejecutarlos en su propio hardware. MiniMax M3 es uno de los modelos de pesos abiertos más capaces de 2026: unos 428.000 millones de parámetros, un contexto de un millón de tokens y texto, imagen y vídeo como entrada. También es lo bastante grande como para que 'ejecutarlo tú mismo' necesite un plan de verdad. Esto es lo que es M3, lo que dicen de verdad las cifras, lo que exige alojarlo y cuándo lo usaría.
Leer el artículo10 min de lectura
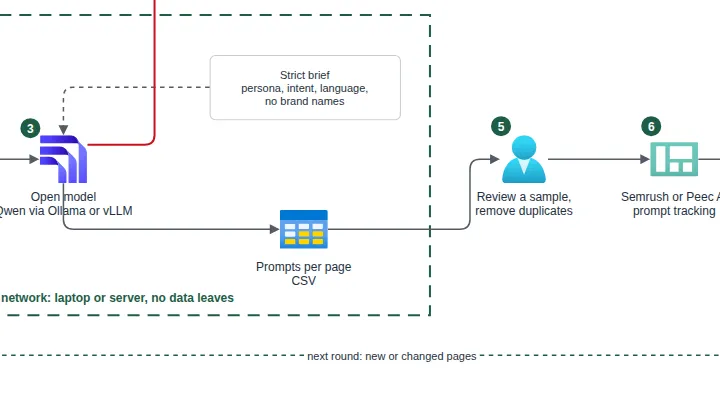
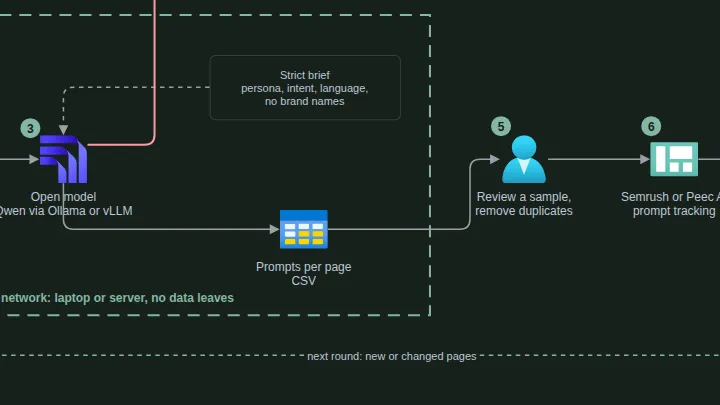
Para saber si los asistentes de IA te recomiendan necesitas las preguntas que tus clientes les hacen de verdad, por página, por intención y por idioma. Escribir cientos a mano no funciona, y enviar el contenido de tus páginas y notas internas a una API pública de IA no siempre está permitido. Este es el flujo que uso: un modelo abierto como Qwen corre en tu propio equipo y convierte tu sitemap en un conjunto realista de prompts, que luego una herramienta como Semrush o Peec AI ejecuta cada día.
Leer el artículo11 min de lectura
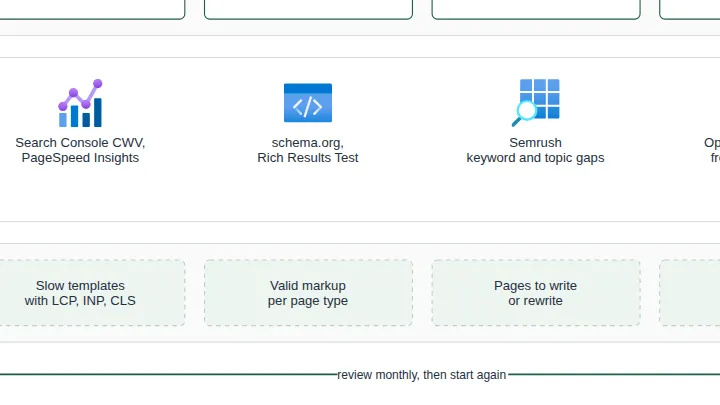
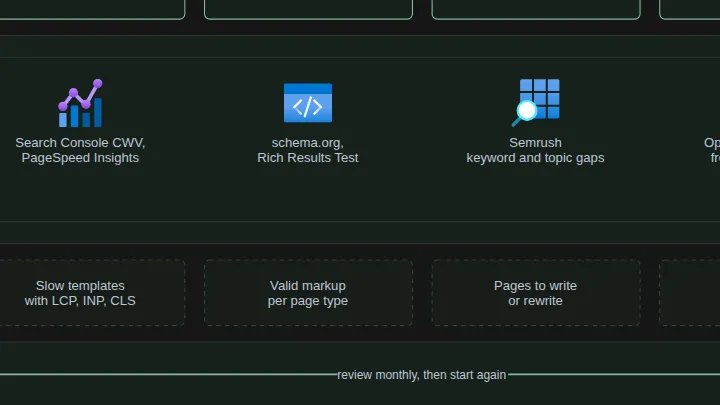
La mayoría de las auditorías que veo son o bien una exportación SEO de 200 páginas que nadie lee, o bien una diapositiva que dice 'ser visible en ChatGPT'. Ninguna cambia nada. Esta es la auditoría que hago de verdad: seis pasos, siempre en el mismo orden, desde '¿pueden las máquinas llegar a ti?' hasta '¿te citan y va a mejor?'. Cada paso termina con una lista breve de correcciones, ordenadas por impacto.
Leer el artículo11 min de lectura
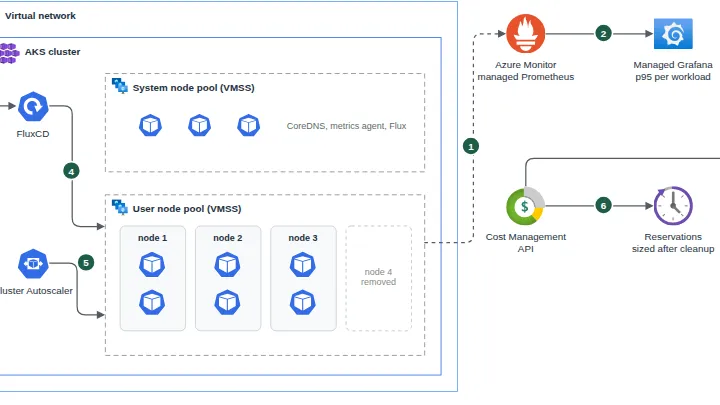
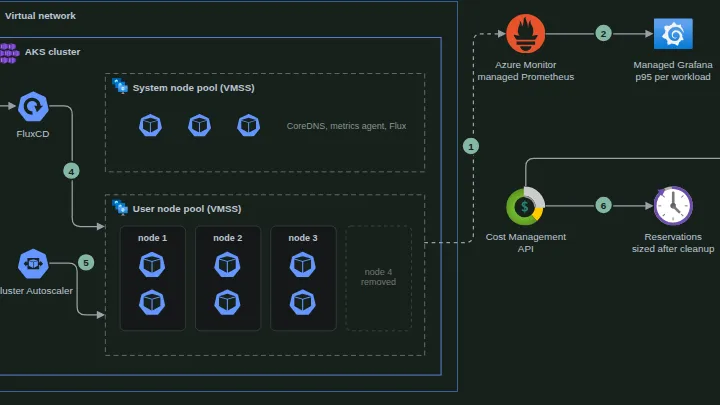
La mayoría de los clústeres funcionan a base de suposiciones: requests copiados de un tutorial, node pools dimensionados para un lanzamiento de hace dos años y una factura cloud que nadie sabe explicar línea a línea. Cada mes pagas capacidad que está parada, y cada mes parece demasiado arriesgado tocarla. El right-sizing lo arregla sin cambiar nada que vean tus clientes. Este es exactamente el orden que sigo, con las consultas, los manifiestos y los comandos, y así un clúster de producción pasó de 7 a 4 nodos sin que ningún cliente lo notara.
Leer el artículo11 min de lectura
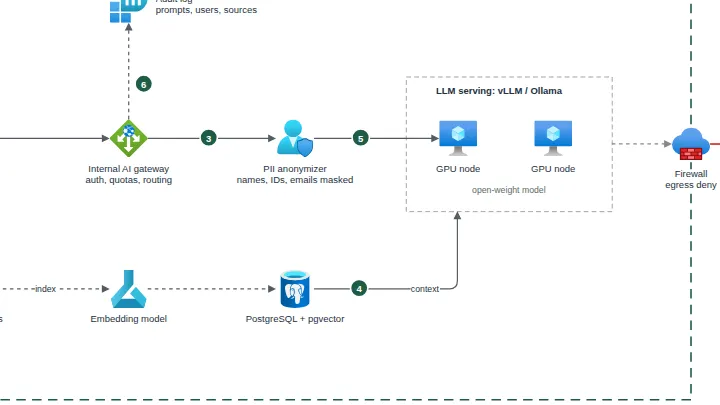
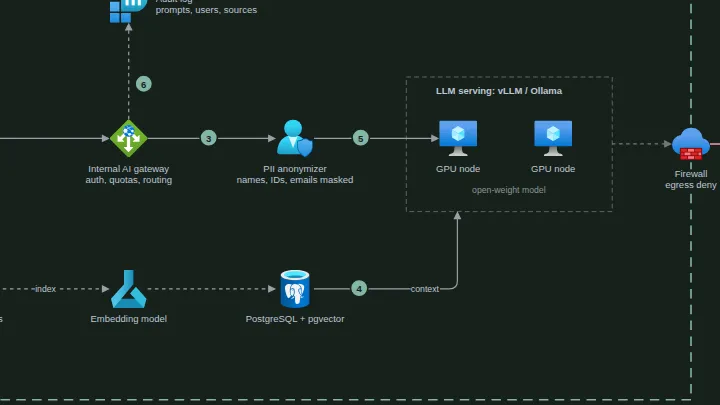
Historias clínicas, contratos de clientes, cifras financieras sin publicar: hay datos que nunca deben llegar a una API pública de IA, y tu equipo de seguridad tiene razón en exigirlo. Normalmente ahí termina la conversación sobre IA, y quienes más se beneficiarían siguen copiando texto a mano. No tiene por qué ser así. Esta es la arquitectura que uso para IA privada dentro de tu propia red: primero un conjunto de pruebas, luego el modelo más pequeño que lo supere, recuperación que respeta los permisos, un anonimizador en el borde y una auditoría de todo.
Leer el artículo11 min de lectura
Los generadores de apps como Lovable, Bolt o v0 te dan un producto que funciona en pocos días. Luego llegan clientes reales, pagos y datos personales, y el prototipo empieza a parecer frágil: un cambio pequeño rompe el checkout, nadie sabe si las copias de seguridad funcionan y la IA que lo construyó sigue reescribiendo cosas. El consejo habitual es reescribirlo. Yo he llevado dos prototipos así a producción sin reescribirlos. Estas son las capas que añado, en este orden, y por qué el orden importa.
Leer el artículo